
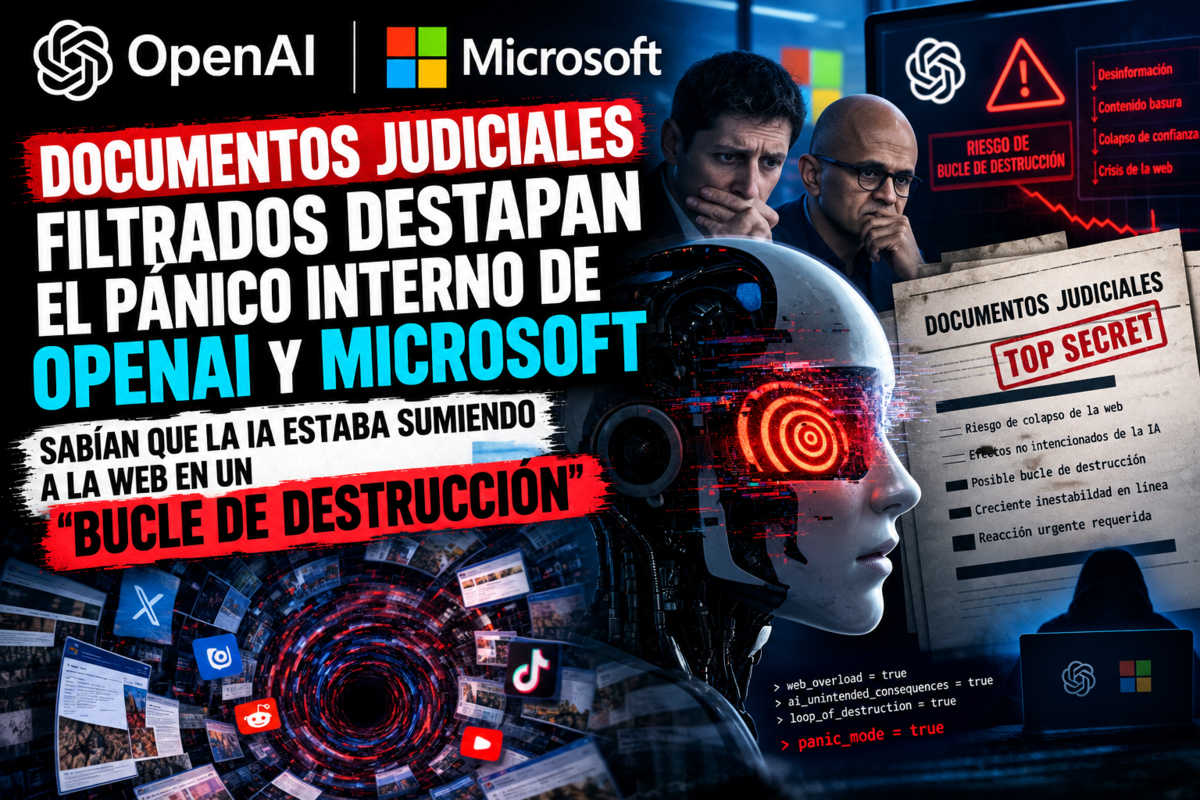
Terremoto judicial y ético en el corazón del sector tecnológico. Una batería de documentos internos desclasificados en la demanda de The New York Times contra OpenAI y Microsoft ha sacado a la luz la aterradora trastienda de la industria. Lejos del optimismo público, ejecutivos e ingenieros de ambas firmas eran plenamente conscientes de que el entrenamiento de sus modelos de inteligencia artificial y la llegada de la era «Google Zero» estaban destruyendo la economía de la web abierta.
Las comunicaciones desvelan que en las oficinas de las grandes tecnológicas se llegó a definir el raspado masivo de datos sin licencia como «el mayor robo de trabajo de la historia humana» y una mofa directa a las leyes de derechos de autor.
Las confesiones más demoledoras del sumario judicial
Los archivos judiciales desclasificados muestran una colección de advertencias internas que dejan en evidencia la narrativa de la industria:
- El espiral del «Doom Loop» o bucle de destrucción: Documentos de Microsoft advirtieron de un círculo vicioso inevitable: la IA devora el tráfico de los medios, destruye su modelo de negocio y, al matar a los creadores de contenido, la propia IA se queda sin datos de calidad para seguir entrenándose.
- Camino inevitable hacia el «Google Zero»: Los analistas internos de OpenAI estimaron que la entrega de respuestas directas por IA reducía hasta un 60% el tráfico hacia los medios de comunicación, impulsando un escenario donde los buscadores dejan de enviar visitas a las webs de origen.
- Citas explosivas de altos cargos: Cargos científicos de Microsoft llegaron a calificar el uso de contenido ajeno como un abuso flagrante del fair use, mientras que en la cúpula de OpenAI se calculaban beneficios multimillonarios a costa de la ingesta masiva de datos.
- Control de daños a la desesperada: Tras la filtración, portavoces oficiales han intentado restar importancia a los textos asegurando que las declaraciones corresponden a la opinión académica personal de empleados y no a la postura oficial de las empresas.
Un golpe devastador a la defensa del ‘Fair Use’
La publicación de estos archivos supone un misil en la línea de flotación para las defensas legales de la inteligencia artificial generativa. Si los propios creadores de ChatGPT reconocían en privado que su tecnología hundía el tráfico de las fuentes originales y sobrepasaba los límites del uso justo, los tribunales lo tendrán mucho más fácil para exigir indemnizaciones históricas y licencias obligatorias.
